آنتروپیک یک ابزار جدید برای ارزیابی پلاگینهای Claude Code منتشر کرده که به توسعهدهندهها اجازه میدهد پیش از انتشار، عملکرد واقعی اسکیلها (Skills) را با داده و عدد بسنجند، نه فقط حدس بزنند که کار میکنند یا نه.
دستور claude plugin eval چه میکند
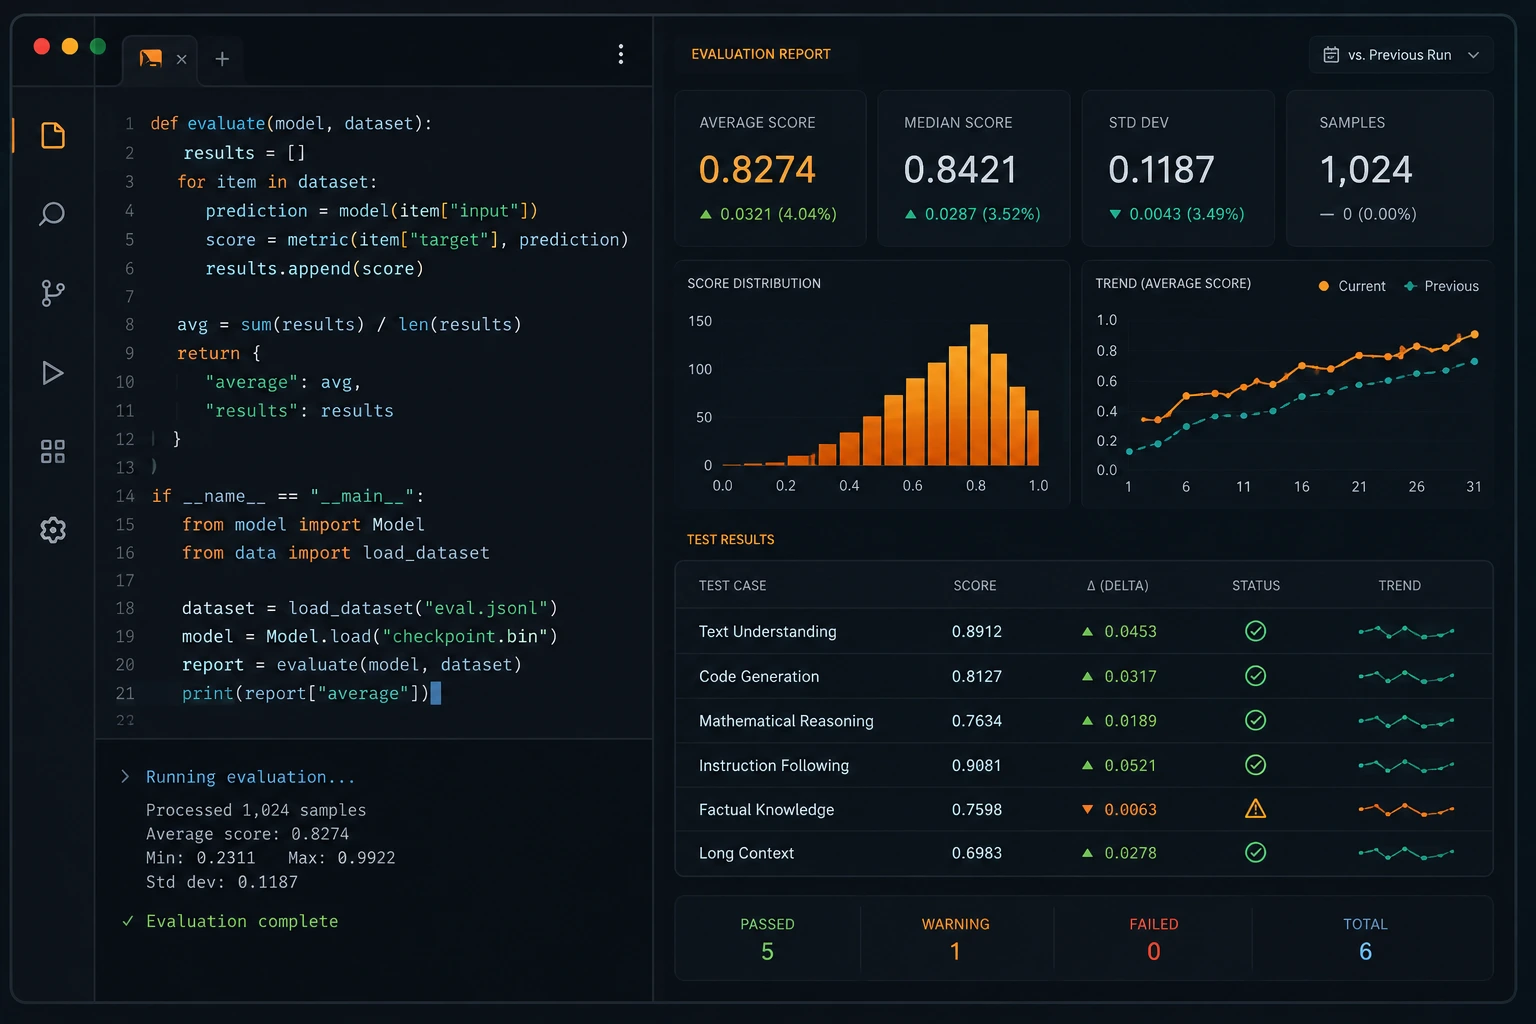
این ابزار از طریق دستور claude plugin eval روی هر پوشهای اجرا میشود که یک فایل plugin.json یا .claude-plugin/plugin.json داشته باشد. دستور، پلاگین را با چند پرامپت واقعی اجرا میکند، خروجی Claude را نمره میدهد و نتیجه را با حالتی که پلاگین اصلاً بارگذاری نشده مقایسه میکند. به این ترتیب سه سوالی که تا پیش از این توسعهدهندهها راه دقیقی برای اندازهگیریش نداشتند، پاسخ داده میشود: آیا اسکیل اصلاً فعال میشود؟ آیا بعد از یک ویرایش یا تغییر مدل هم درست کار میکند؟ و آیا واقعاً نسبت به یک مدل خام بهتر عمل میکند؟
این ابزار روی Claude Code نسخهی ۲.۱.۲۶۹ به بعد کار میکند و هر اجرای ارزیابی، یک فراخوانی واقعی مدل است که از حساب کاربری یا API هزینه میکند.
ساختار یک کیس ارزیابی
هر مجموعهی ارزیابی داخل پوشهی evals/ پلاگین قرار میگیرد. هر کیس یک زیرپوشه است که شامل یک فایل prompt.md و یک پوشهی graders/ میشود. متن پرامپت دقیقاً همانطور که نوشته شده به Claude داده میشود. در فرانتمَتر فایل پرامپت میتوان مقادیری مثل max_turns (پیشفرض ۱۰)، timeout_seconds (پیشفرض ۳۰۰)، model، tags و allowed_tools را تنظیم کرد.
گریدرها هم فایلهای مارکداون هستند که در فرانتمتر خود یک type، و بهصورت اختیاری weight و arm را مشخص میکنند. در مجموع شش نوع گریدر وجود دارد: چهار نوع — regex، tool_used، tool_order و file_exists — رایگاناند چون فقط از روی ترنسکریپت و فایلهای روی دیسک محاسبه میشوند. دو نوع دیگر — llm و baseline — یک مدل داور را فرامیخوانند و هزینهبردارند؛ llm پاسخ را در برابر معیارهای نوشتهشده بهصورت متنی میسنجد و baseline آن را با یک پاسخ مرجع مقایسه میکند.
دستور claude plugin eval init هم بهصورت خودکار پلاگین را میخواند، از کاربر میپرسد یک نتیجهی خوب چه شکلی است، کیسها و گریدرهای پیشنهادی را میسازد، آنها را امتحان میکند و فایلهای نهایی را مینویسد.
عدد کلیدی: دلتا (Δ)
بهطور پیشفرض هر کیس دوبار اجرا میشود: یکبار با پلاگین بارگذاریشده و یکبار بدون آن. تفاوت این دو نتیجه، که آنتروپیک آن را Δ مینامد، دقیقاً نشان میدهد پلاگین چقدر واقعاً تأثیر داشته است. اگر یک کیس در هر دو حالت نمرهی یکسان بگیرد، یعنی پلاگین دلیل موفقیت آن نبوده. در نمونهی مستندات رسمی، یک کیس در حالت «با پلاگین» نمرهی ۱.۰۰ و در حالت «بدون پلاگین» نمرهی ۰.۳۳ گرفته که Δ برابر با ۰.۶۷+ میشود، با هزینهی تخمینی حدود ۰.۴۱ دلار و زمان اجرای ۷۴ ثانیه در مجموع ۶ اجرا.
طبق گفتهی آنتروپیک، رایجترین مشکلی که این ابزار آشکار میکند، Δ نزدیک به صفر همراه با شکستخوردن گریدر tool_used: Skill است؛ یعنی Claude با عبارتهای طبیعی کاربر، اصلاً سراغ آن اسکیل نمیرود. این دقیقاً همان نقصی است که ابزار قبلیِ اعتبارسنجی، یعنی claude plugin validate، نمیتواند تشخیص دهد؛ چون آن ابزار فقط ساختار و فرمت مانیفست را چک میکند، نه رفتار واقعی پلاگین را.
نتایج هر اجرا در مسیر evals/results/<timestamp>/report.html ذخیره میشود و شامل نتیجهی هر گریدر و رأیهای مدل داور است. در حسابهایی که امکانش را داشته باشند، این گزارش بهصورت پیشفرض روی claude.ai هم منتشر میشود، مگر اینکه با فلگ --no-publish غیرفعال شود.
استفاده در CI
آنتروپیک یک دستور نمونه هم برای CI منتشر کرده، با فلگهایی مثل --trust-plugin، --threshold، --model، --judge-model، --no-publish و --max-cost-usd، تا افت کیفیت یک پلاگین پیش از انتشار خودکار شناسایی شود. اجرا به یک نصب Claude Code و اعتبارنامهای مثل ANTHROPIC_API_KEY نیاز دارد؛ بدون --trust-plugin، اجرای پلاگین از منبع نامعتبر در محیط بدون ترمینال رد میشود.
سوالات متداول
ابزار ارزیابی پلاگین Claude Code چه مشکلی را حل میکند؟ تا پیش از این، توسعهدهندهها راه قابلاتکایی برای سنجش اینکه آیا یک اسکیل واقعاً فعال میشود و ارزش افزوده دارد یا نه، نداشتند. این ابزار با مقایسهی عملکرد با و بدون پلاگین، این را با عدد نشان میدهد.
فرق آن با claude plugin validate چیست؟
validate فقط ساختار و فرمت مانیفست پلاگین را چک میکند؛ ابزار ارزیابی، رفتار واقعی پلاگین روی پرامپتهای واقعی را میسنجد.
آیا اجرای ارزیابی هزینه دارد؟
هر اجرا حداقل یک فراخوانی مدل واقعی است. گریدرهای regex، tool_used، tool_order و file_exists رایگاناند، اما گریدرهای llm و baseline از مدل داور استفاده میکنند و هزینهبردارند.
این ابزار روی چه نسخهای از Claude Code کار میکند؟ Claude Code نسخهی ۲.۱.۲۶۹ به بعد.
جمعبندی
با معرفی ابزار ارزیابی پلاگین، آنتروپیک عملاً یک لایهی سنجش کمّی به اکوسیستم پلاگینهای Claude Code اضافه کرده که پیشتر وجود نداشت. برای توسعهدهندههایی که اسکیل میسازند، این یعنی امکان تشخیص زودهنگام اینکه آیا یک پلاگین واقعاً روی پرامپتهای طبیعی فعال میشود یا فقط در تستهای دستی جواب میدهد.
منبع: MarkTechPost
نظرات
برای ثبت نظر وارد شوید.